AI Model Families for Local Inference
Browse open-weight model families you can run locally with Ollama. Each family page shows all variants, RAM requirements, device compatibility, and performance expectations.
Quality-gated, not inflated
ModelFit tracks 152 models across 26 families, with 113 local rows. Every Ollama command is registry-verified before it ships, and low-quality 2-bit quants stay out of the ranking even when they technically exist.
AI Model Families for Local Use
 Alibaba Cloud
Qwen is Alibaba Cloud's open-weight model family spanning 0.5B to 2.4T parameters. Qwen3.8 27B is the local flagship: a dense, Apache 2.0 vision-language model, while the Qwen3.8 2.4T A95B MoE tops the cloud line.
 Meta
Llama is Meta's open-weight model family and the most popular choice for local AI. The Llama 4 line brings multimodal MoE models for big-memory machines, while the 1B-70B Llama 3.x sizes remain the practical laptop and desktop picks.
 DeepSeek AI
DeepSeek now ships two distinct lines. The V4 generation is cloud-first: V4.1 Flash is an MIT-licensed multimodal image + text MoE, and V4 Flash 0731 and V4 Pro are API models. On consumer hardware DeepSeek means the R1 reasoning distills, from 7B up to the full 671B, all registry-verified in Ollama.
 Mistral AI
's models are known for efficiency and strong performance relative to their size. Mistral 7B was a breakthrough that proved small models could compete with much larger ones.
 Google DeepMind
Gemma is Google DeepMind's efficient open model family, tuned for strong quality at small sizes. The Gemma 4 line spans an on-device 4.5B model up to a dense 31B and a 26B MoE, all Apache 2.0.
 Microsoft
Phi is Microsoft's small-but-mighty model family, built on the idea that careful training data beats raw parameter count. Phi-4 Mini packs strong reasoning into just 3.8B parameters, while Phi-4 14B competes with much larger models on quality. Both run locally with Ollama and pair naturally with low-RAM Apple Silicon Macs.
 Liquid AI
LFM2 is Liquid AI's efficiency-focused model family, built on a hybrid architecture rather than a standard dense transformer. Its flagship, LFM2 24B-A2B, is a sparse mixture-of-experts model that activates only 2B of its 24B parameters per token. That design makes it fast on consumer hardware and well suited to agent workflows, tool calling, and privacy-sensitive local setups.
 Hugging Face
SmolLM is Hugging Face's ultra-tiny model family for the most constrained devices. SmolLM2 360M loads in about 0.5GB and runs on anything with 1GB of RAM, from old Macs and iPhones to embedded boards. It is the smallest model in our database and the fastest by speed score.
API-only & open-weights flagships
Frontier models you don't run on a laptop — hosted APIs, often with open weights. Each page says what it does and lists the local alternatives that actually fit your machine.
Full Model Catalog
Filter every tracked model by RAM, family, runtime and context budget. Load figures and fit rules come from the same dataset that powers the wizard.
| Family | Quant | Local | ollama | ||||
|---|---|---|---|---|---|---|---|
| Qwen2.5 1.5B Instruct | Qwen | 1.5B | Q4_K_M | 4 GB | ~1.5 GB | Yes | qwen2.5:1.5b-instruct-q4_K_M |
| Qwen2.5 3B Instruct | Qwen | 3B | Q4_K_M | 4 GB | ~2.5 GB | Yes | qwen2.5:3b-instruct-q4_K_M |
| Qwen2.5 7B Instruct | Qwen | 7B | Q4_K_M | 8 GB | ~5.5 GB | Yes | qwen2.5:7b-instruct-q4_K_M |
| Qwen2.5 14B Instruct | Qwen | 14B | Q4_K_M | 16 GB | ~11 GB | Yes | qwen2.5:14b-instruct-q4_K_M |
| Llama 3.2 3B Instruct | Llama | 3B | Q4_K_M | 4 GB | ~2.5 GB | Yes | llama3.2:3b-instruct-q4_K_M |
| Llama 3.1 8B Instruct | Llama | 8B | Q4_K_M | 12 GB | ~6.5 GB | Yes | llama3.1:8b-instruct-q4_K_M |
| Llama 3.1 8B Instruct (Q8) | Llama | 8B | Q8_0 | 16 GB | ~8 GB | Yes | llama3.1:8b-instruct-q8_0 |
| Llama 3.1 8B Instruct (Q5) | Llama | 8B | Q5_K_M | 12 GB | ~8 GB | Yes | llama3.1:8b-instruct-q5_K_M |
| Llama 3.1 70B Instruct | Llama | 70B | Q4_K_M | 64 GB | ~42 GB | Yes | llama3.1:70b-instruct-q4_K_M |
| Mistral 7B Instruct | Mistral | 7B | Q4_K_M | 8 GB | ~5.5 GB | Yes | mistral:7b-instruct-q4_K_M |
| Mistral 7B Instruct (Q5) | Mistral | 7B | Q5_K_M | 8 GB | ~4.8 GB | Yes | mistral:7b-instruct-q5_K_M |
| Mistral 7B Instruct (Q8) | Mistral | 7B | Q8_0 | 16 GB | ~7.2 GB | Yes | mistral:7b-instruct-q8_0 |
| Mixtral 8x7B Instruct | Mistral | 46.7B | Q4_K_M | 48 GB | ~30 GB | Yes | mixtral:8x7b |
| Mistral Nemo 12B | Mistral | 12B | Q4_K_M | 16 GB | ~9.5 GB | Yes | mistral-nemo:12b |
| Mistral Nemo 12B (Q8) | Mistral | 12B | Q8_0 | 24 GB | ~12.1 GB | Yes | mistral-nemo:12b-instruct-2407-q8_0 |
| Gemma 2 2B Instruct | Gemma | 2B | Q4_K_M | 4 GB | ~1.8 GB | Yes | gemma2:2b-instruct-q4_K_M |
| Gemma 2 9B Instruct | Gemma | 9B | Q4_K_M | 12 GB | ~7 GB | Yes | gemma2:9b-instruct-q4_K_M |
| Gemma 2 27B Instruct | Gemma | 27B | Q4_K_M | 32 GB | ~21 GB | Yes | gemma2:27b-instruct-q4_K_M |
| Phi-3 Mini 3.8B | Phi | 3.8B | Q4_K_M | 6 GB | ~3.2 GB | Yes | phi3:mini |
| Phi-3 Medium 14B | Phi | 14B | Q4_K_M | 16 GB | ~11 GB | Yes | phi3:medium |
| Phi-4 14B | Phi | 14B | Q4_K_M | 24 GB | ~11.5 GB | Yes | phi4:14b-q4_K_M |
| Phi-4 14B (Q8) | Phi | 14B | Q8_0 | 24 GB | ~14.5 GB | Yes | phi4:14b-q8_0 |
| Qwen2.5 Coder 7B | Qwen | 7B | Q4_K_M | 8 GB | ~5.5 GB | Yes | qwen2.5-coder:7b |
| Qwen2.5 Coder 14B | Qwen | 14B | Q4_K_M | 16 GB | ~11 GB | Yes | qwen2.5-coder:14b |
| Llama 3.2 1B Instruct | Llama | 1B | Q4_K_M | 2 GB | ~1 GB | Yes | llama3.2:1b-instruct-q4_K_M |
| Mistral Small 22B | Mistral | 22B | Q4_K_M | 32 GB | ~17 GB | Yes | mistral-small:22b |
| Kimi K2 Instruct | Kimi | 1000B | API | 0 GB | — | Open, no fit | — |
| Claude 3.5 Sonnet | Claude | Undisclosed | API | 0 GB | — | Cloud | — |
| Claude 3.7 Sonnet | Claude | Undisclosed | API | 0 GB | — | Cloud | — |
| Claude 3 Opus | Claude | Undisclosed | API | 0 GB | — | Cloud | — |
| Claude 4 Opus | Claude | Undisclosed | API | 0 GB | — | Cloud | — |
| Qwen2.5 0.5B Instruct | Qwen | 0.5B | Q4_K_M | 2 GB | ~0.8 GB | Yes | qwen2.5:0.5b-instruct-q4_K_M |
| Gemma 3 1B Instruct | Gemma | 1B | Q4_K_M | 2 GB | ~1 GB | Yes | gemma3:1b |
| Gemma 3 1B Instruct (Q8) | Gemma | 1B | Q8_0 | 4 GB | ~1 GB | Yes | gemma3:1b-it-q8_0 |
| Phi-4 Mini 3.8B | Phi | 3.8B | Q4_K_M | 6 GB | ~3.2 GB | Yes | phi4-mini:3.8b |
| Phi-4 Mini 3.8B (Q8) | Phi | 3.8B | Q8_0 | 8 GB | ~3.8 GB | Yes | phi4-mini:3.8b-q8_0 |
| SmolLM2 360M | SmolLM | 0.36B | Q4_K_M | 1 GB | ~0.5 GB | Yes | smollm2:360m |
| Llama 3.3 70B Instruct | Llama | 70B | Q4_K_M | 64 GB | ~42 GB | Yes | llama3.3:70b-instruct-q4_K_M |
| Llama 3.1 405B Instruct | Llama | 405B | Q4_K_M | 320 GB | ~243 GB | Yes | llama3.1:405b-instruct-q4_K_M |
| DeepSeek-R1 671B | DeepSeek | 671B | Q4_K_M | 512 GB | ~380 GB | Yes | deepseek-r1:671b-q4_K_M |
| Qwen3 8B | Qwen | 8B | Q4_K_M | 12 GB | ~6.5 GB | Yes | qwen3:8b-q4_K_M |
| Qwen3 8B (Q8) | Qwen | 8B | Q8_0 | 16 GB | ~8.1 GB | Yes | qwen3:8b-q8_0 |
| Qwen3 14B | Qwen | 14B | Q4_K_M | 16 GB | ~11 GB | Yes | qwen3:14b-q4_K_M |
| Qwen3 30B | Qwen | 30B | Q4_K_M | 32 GB | ~22 GB | Yes | qwen3:30b |
| Qwen3 30B (Q8) | Qwen | 30B | Q8_0 | 48 GB | ~30.3 GB | Yes | qwen3:30b-a3b-q8_0 |
| Gemma 3 4B Instruct | Gemma | 4B | Q4_K_M | 6 GB | ~3.5 GB | Yes | gemma3:4b |
| Gemma 3 4B Instruct (Q8) | Gemma | 4B | Q8_0 | 8 GB | ~3.9 GB | Yes | gemma3:4b-it-q8_0 |
| Gemma 3 12B Instruct | Gemma | 12B | Q4_K_M | 16 GB | ~9.5 GB | Yes | gemma3:12b |
| Gemma 3 27B Instruct | Gemma | 27B | Q4_K_M | 32 GB | ~21 GB | Yes | gemma3:27b |
| DeepSeek-R1 Distill Qwen 7B | DeepSeek | 7B | Q4_K_M | 8 GB | ~5.5 GB | Yes | deepseek-r1:7b |
| DeepSeek-R1 Distill Qwen 7B (Q8) | DeepSeek | 7B | Q8_0 | 16 GB | ~7.5 GB | Yes | deepseek-r1:7b-qwen-distill-q8_0 |
| DeepSeek-R1 Distill Qwen 14B | DeepSeek | 14B | Q4_K_M | 16 GB | ~11 GB | Yes | deepseek-r1:14b |
| DeepSeek-R1 Distill Qwen 14B (Q8) | DeepSeek | 14B | Q8_0 | 24 GB | ~14.6 GB | Yes | deepseek-r1:14b-qwen-distill-q8_0 |
| DeepSeek-R1 Distill Llama 70B | DeepSeek | 70B | Q4_K_M | 64 GB | ~42 GB | Yes | deepseek-r1:70b |
| GPT-4o | OpenAI | Undisclosed | API | 0 GB | — | Cloud | — |
| GPT-4o mini | OpenAI | Undisclosed | API | 0 GB | — | Cloud | — |
| Claude 4 Sonnet | Claude | Undisclosed | API | 0 GB | — | Cloud | — |
| Gemini 2.5 Pro | Undisclosed | API | 0 GB | — | Cloud | — | |
| Gemini 2.5 Flash | Undisclosed | API | 0 GB | — | Cloud | — | |
| DeepSeek-V3 | DeepSeek | 671B | API | 0 GB | — | Open, no fit | — |
| GLM-5 | Zhipu | 744B | API | 0 GB | — | Open, no fit | — |
| GLM-4 Plus | Zhipu | Undisclosed | API | 0 GB | — | Cloud | — |
| Qwen3 235B A22B | Qwen | 235B | Q4_K_M | 192 GB | ~130 GB | Yes | qwen3:235b-a22b-q4_K_M |
| Mistral Small 3.1 | Mistral | 24B | Q4_K_M | 24 GB | ~15 GB | Yes | mistral-small3.1:24b |
| Mistral Small 3.1 (Q8) | Mistral | 24B | Q8_0 | 36 GB | ~23.3 GB | Yes | mistral-small3.1:24b-instruct-2503-q8_0 |
| DeepSeek-V3-0324 | DeepSeek | 671B | API | 0 GB | — | Open, no fit | — |
| DeepSeek-R1 | DeepSeek | 671B | API | 0 GB | — | Open, no fit | — |
| Qwen3.5 0.8B Instruct | Qwen | 0.8B | Q4_K_M | 2 GB | ~0.8 GB | Yes | qwen3.5:0.8b |
| Qwen3.5 2B Instruct | Qwen | 2B | Q4_K_M | 4 GB | ~1.8 GB | Yes | qwen3.5:2b |
| Qwen3.5 4B Instruct | Qwen | 4B | Q4_K_M | 6 GB | ~3.5 GB | Yes | qwen3.5:4b |
| Qwen3.5 4B Instruct (Q8) | Qwen | 4B | Q8_0 | 8 GB | ~4.3 GB | Yes | qwen3.5:4b-q8_0 |
| Qwen3.5 9B Instruct | Qwen | 9B | Q4_K_M | 12 GB | ~7 GB | Yes | qwen3.5:9b |
| Qwen3.5 35B-A3B Instruct | Qwen | 35B | Q4_K_M | 32 GB | ~20 GB | Yes | qwen3.5:35b-a3b |
| Qwen3.5 27B Instruct | Qwen | 27B | Q4_K_M | 24 GB | ~16 GB | Yes | qwen3.5:27b |
| Qwen3.5 27B Instruct (Q8) | Qwen | 27B | Q8_0 | 48 GB | ~27.1 GB | Yes | qwen3.5:27b-q8_0 |
| Qwen3.5 122B-A10B Instruct | Qwen | 122B | Q4_K_M | 96 GB | ~72 GB | Yes | qwen3.5:122b-a10b |
| LFM2 24B-A2B Instruct | LFM2 | 24B | Q4_K_M | 24 GB | ~14 GB | Yes | lfm2:24b-a2b |
| LFM2.5 8B-A1B | LFM2 | 8.3B | Q4_K_M | 8 GB | ~5.5 GB | Yes | lfm2.5:8b-a1b-q4_K_M |
| Granite 4.1 3B Instruct | Granite | 3B | Q4_K_M | 4 GB | ~2 GB | Yes | granite4.1:3b |
| Granite 4.1 8B Instruct | Granite | 8B | Q4_K_M | 8 GB | ~5.5 GB | Yes | granite4.1:8b |
| Qwen3.6 27B | Qwen | 27B | Q4_K_M | 32 GB | ~18 GB | Yes | qwen3.6:27b |
| Qwen3.8 27B | Qwen | 27B | Q4_K_M | 24 GB | ~16.5 GB | Yes | qwen3.8:27b |
| Qwen3.8 27B (Q8) | Qwen | 27B | Q8_0 | 48 GB | ~27.1 GB | Yes | qwen3.8:27b-q8_0 |
| Qwen3.6 35B-A3B | Qwen | 35B | Q4_K_M | 32 GB | ~22 GB | Yes | qwen3.6:35b-a3b |
| Gemma 4 31B | Gemma | 31B | Q4_K_M | 32 GB | ~20 GB | Yes | gemma4:31b |
| Gemma 4 31B (Q8) | Gemma | 31B | Q8_0 | 48 GB | ~30.9 GB | Yes | gemma4:31b-it-q8_0 |
| Gemma 4 26B-A4B | Gemma | 26B | Q4_K_M | 24 GB | ~16 GB | Yes | gemma4:26b |
| Gemma 4 E4B | Gemma | 4.5B | Q4_K_M | 6 GB | ~4 GB | Yes | gemma4:e4b |
| Gemma 4 E4B (Q8) | Gemma | 4.5B | Q8_0 | 16 GB | ~7.5 GB | Yes | gemma4:e4b-it-q8_0 |
| Gemma 4 E2B | Gemma | 2.3B | Q4_K_M | 4 GB | ~2.3 GB | Yes | gemma4:e2b |
| Gemma 4 E2B (Q8) | Gemma | 2.3B | Q8_0 | 8 GB | ~4.6 GB | Yes | gemma4:e2b-it-q8_0 |
| Llama 4 Scout | Llama | 109B | Q4_K_M | 96 GB | ~67 GB | Yes | llama4:scout |
| Llama 4 Maverick | Llama | 400B | Q4_K_M | 320 GB | ~245 GB | Yes | llama4:maverick |
| Mistral Medium 3.5 | Mistral | 128B | API | 0 GB | — | Open (llama.cpp) | — |
| DeepSeek V4 Flash 0731 | DeepSeek | 284B | API | 0 GB | — | Open (llama.cpp) | — |
| DeepSeek V4 Pro | DeepSeek | 1600B | API | 0 GB | — | Open, no fit | — |
| DeepSeek V4.1 Flash | DeepSeek | 552B | API | 0 GB | — | Open, no fit | — |
| Kimi K2.6 | Kimi | 1000B | API | 0 GB | — | Open, no fit | — |
| GLM-5.1 | Zhipu | 744B | API | 0 GB | — | Open, no fit | — |
| Claude Opus 4.7 | Claude | Undisclosed | API | 0 GB | — | Cloud | — |
| Claude Opus 4.8 | Claude | Undisclosed | API | 0 GB | — | Cloud | — |
| GPT-5.5 | OpenAI | Undisclosed | API | 0 GB | — | Cloud | — |
| Gemini 3.1 Pro | Undisclosed | API | 0 GB | — | Cloud | — | |
| Grok 4.3 | xAI | Undisclosed | API | 0 GB | — | Cloud | — |
| Gemma 4 12B | Gemma | 12B | Q4_K_M | 12 GB | ~8 GB | Yes | gemma4:12b |
| Claude Fable 5 | Claude | Undisclosed | API | 0 GB | — | Cloud | — |
| GLM-5.2 | Zhipu | 753B | API | 0 GB | — | Open, no fit | — |
| Kimi K2.7-Code | Kimi | 1000B | API | 0 GB | — | Open, no fit | — |
| MiniMax M3 | MiniMax | 428B | API | 0 GB | — | Open, no fit | — |
| Qwen3.7-Plus | Qwen | Undisclosed | API | 0 GB | — | Cloud | — |
| NVIDIA Nemotron 3 Ultra | Nemotron | 550B | API | 0 GB | — | Open, no fit | — |
| Xiaomi MiMo-V2-Flash | MiMo | 309B | API | 0 GB | — | Open (llama.cpp) | — |
| NVIDIA Nemotron Cascade 2 30B-A3B | Nemotron | 30B | Q6_K | 36 GB | ~24 GB | Yes | nemotron-cascade-2:30b |
| Poolside Laguna XS.2 | Laguna | 33B | Q4_K_M | 36 GB | ~23 GB | Yes | laguna-xs.2:q4_K_M |
| Cohere North Mini Code | North | 30B | Q4_K_M | 32 GB | ~19 GB | Yes | north-mini-code-1.0:q4_K_M |
| GPT-OSS 120B | GPT-OSS | 117B | MXFP4 | 96 GB | ~65.4 GB | Yes | gpt-oss:120b |
| GPT-OSS 20B | GPT-OSS | 21B | MXFP4 | 24 GB | ~13.8 GB | Yes | gpt-oss:20b |
| Qwen3-Next 80B-A3B | Qwen | 80B | Q4_K_M | 72 GB | ~50.4 GB | Yes | qwen3-next:80b |
| Qwen3.6 35B-A3B (Q8) | Qwen | 35B | Q8_0 | 64 GB | ~38.7 GB | Yes | qwen3.6:35b-a3b-q8_0 |
| Qwen3.5 35B-A3B Instruct (Q8) | Qwen | 35B | Q8_0 | 64 GB | ~38.7 GB | Yes | qwen3.5:35b-a3b-q8_0 |
| Qwen3.5 9B Instruct (Q8) | Qwen | 9B | Q8_0 | 16 GB | ~10.7 GB | Yes | qwen3.5:9b-q8_0 |
| Qwen3.6 27B (Q8) | Qwen | 27B | Q8_0 | 48 GB | ~30 GB | Yes | qwen3.6:27b-q8_0 |
| Gemma 4 12B (Q8) | Gemma | 12B | Q8_0 | 24 GB | ~12.8 GB | Yes | gemma4:12b-it-q8_0 |
| Gemma 4 26B-A4B (Q8) | Gemma | 26B | Q8_0 | 48 GB | ~28.1 GB | Yes | gemma4:26b-a4b-it-q8_0 |
| Qwen3-Next 80B-A3B (Q8) | Qwen | 80B | Q8_0 | 128 GB | ~84.8 GB | Yes | qwen3-next:80b-a3b-instruct-q8_0 |
| Qwen3 14B (Q8) | Qwen | 14B | Q8_0 | 24 GB | ~15.9 GB | Yes | qwen3:14b-q8_0 |
| Llama 3.3 70B Instruct (Q8) | Llama | 70B | Q8_0 | 96 GB | ~75 GB | Yes | llama3.3:70b-instruct-q8_0 |
| Llama 3.3 70B Instruct (Q6) | Llama | 70B | Q6_K | 96 GB | ~57.9 GB | Yes | llama3.3:70b-instruct-q6_K |
| Kimi K3 | Kimi | 2800B | API | 0 GB | — | Open, no fit | — |
| Laguna XS 2.1 | Laguna | 33B | Q4_K_M | 32 GB | ~20.3 GB | Yes | laguna-xs-2.1:q4_K_M |
| Laguna S 2.1 | Laguna | 118B | Q4_K_M | 128 GB | ~96 GB | Yes | laguna-s-2.1:q4_K_M |
| Ornith 1.0 9B | Ornith | 9B | Q4_K_M | 8 GB | ~5.6 GB | Yes | ornith:9b |
| Ornith 1.0 35B | Ornith | 35B | Q4_K_M | 32 GB | ~21.2 GB | Yes | ornith:35b |
| Qwen3.8-Flash-Next | Qwen | 125B | IQ1_S | 192 GB | ~123 GB | Yes | — |
| Qwen3.8 2.4T A95B | Qwen | 2400B | API | 0 GB | — | Open, no fit | — |
| Granite 4.2 3B | Granite | 3.7B | Q4_K_M | 4 GB | ~2.1 GB | Yes | granite4.2:3b |
| Granite 4.2 8B | Granite | 8.8B | Q4_K_M | 8 GB | ~5 GB | Yes | granite4.2:8b |
| Granite 4.2 30B | Granite | 29.3B | Q4_K_M | 24 GB | ~16.5 GB | Yes | granite4.2:30b |
| Nemotron 3.5 Lightning 30B-A3B | Nemotron | 30B | Q4_K_M | 36 GB | ~23.7 GB | Yes | nemotron-3.5-lightning:30b |
| Muse Glimmer 30B | Muse | 29.8B | Q4_K_M | 32 GB | ~16.9 GB | Yes | muse-glimmer:30b |
| MiniCPM-V 4.5 8B | MiniCPM | 8.7B | Q4_K_M | 12 GB | ~5.7 GB | Yes | minicpm-v4.5:8b |
| GLM-5.3 | Zhipu | 753B | API | 0 GB | — | Open, no fit | — |
| GLM-5.3 Flash | Zhipu | 321B | API | 0 GB | — | Open (llama.cpp) | — |
| GLM-4.7-Flash 30B-A3B | Zhipu | 30B | Q4_K_M | 32 GB | ~19 GB | Yes | glm-4.7-flash |
| Nemotron 3 Super 120B-A12B | Nemotron | 120B | Q4_K_M | 128 GB | ~86.8 GB | Yes | nemotron-3-super:120b |
| Olmo 3.1 32B Instruct | Olmo | 32B | Q4_K_M | 32 GB | ~19.5 GB | Yes | olmo-3.1:32b |
| MiMo-V2.6-Distill-Qwen-9B | MiMo | 9B | Q4_K_M | 16 GB | ~5.8 GB | Yes | — |
| Ling-3.0-flash | Ling | 124B | Q4_K_M | 128 GB | ~77.8 GB | Yes | — |
| Xiaomi MiMo-V2.6-Flash | MiMo | 309B | API | 0 GB | — | Open (llama.cpp) | — |
| Xiaomi MiMo-V2.6-Pro | MiMo | 1020B | API | 0 GB | — | Open, no fit | — |
| Devstral Small 2 24B | Mistral | 24B | Q4_K_M | 24 GB | ~15.2 GB | Yes | devstral-small-2:24b |
| Devstral 2 123B | Mistral | 123B | Q4_K_M | 96 GB | ~74.9 GB | Yes | devstral-2:123b |
How Much RAM Do You Need?
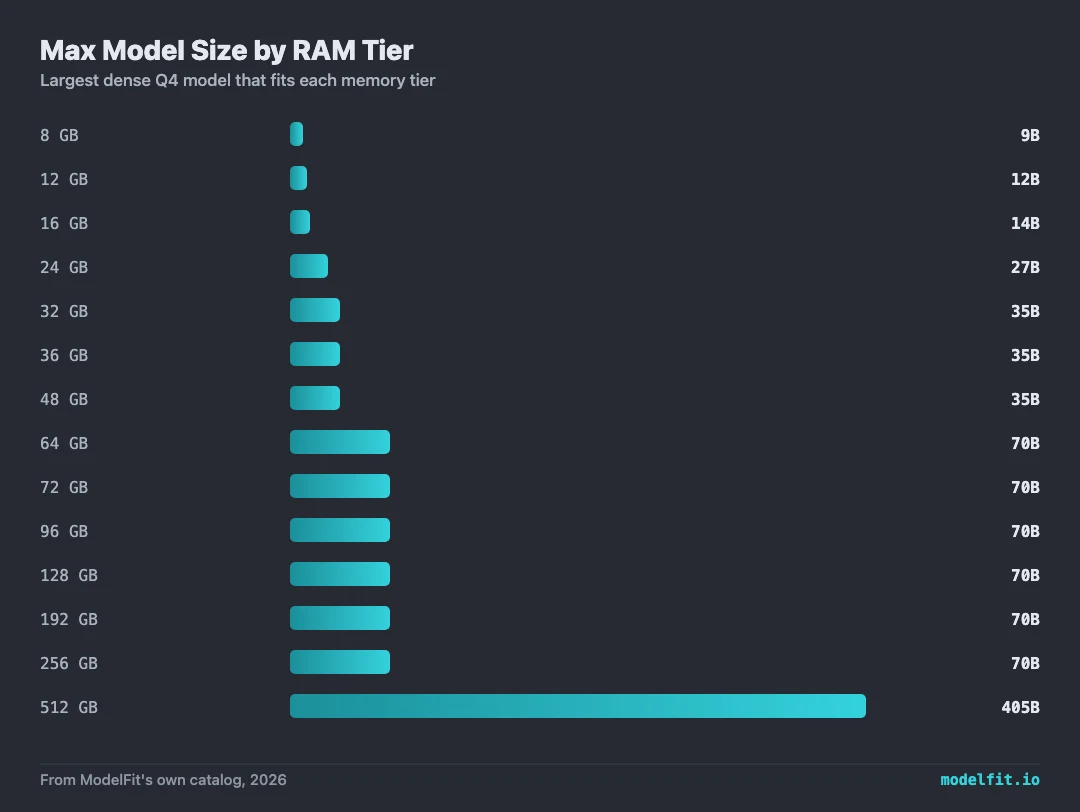
Largest dense Q4 model that fits each memory tier, from ModelFit’s own catalog. Full breakdown on the stats page.