Qwen Models: Local AI from 0.5B to 2.4T
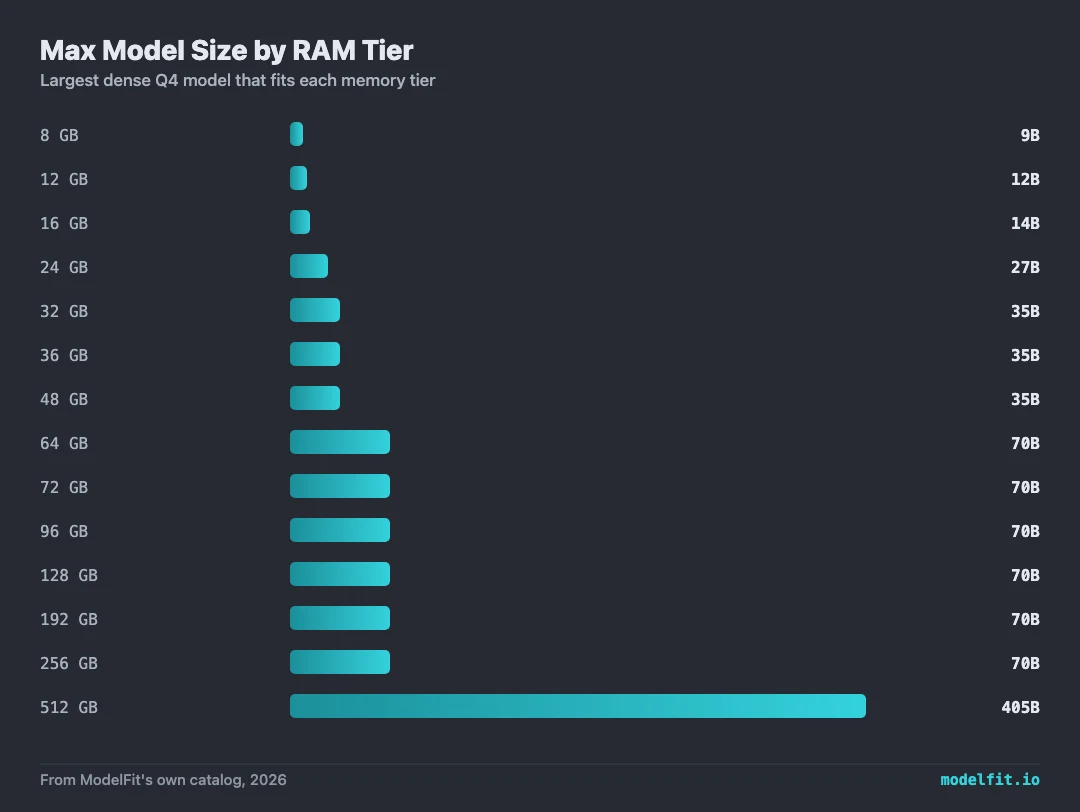
Qwen is the widest open-weight family in the catalog, from 0.5B models that run on iPhones up to the Qwen3.8 2.4T A95B cloud MoE. For local hardware the flagship is Qwen3.8 27B: dense, Apache 2.0, with native vision-language support, 262K context extensible to 1M, and MTP decoding. It runs with `ollama run qwen3.8:27b` on a 24GB machine. Above it, Qwen3.8-Flash-Next is a 125B total / 6B active MoE shipped as a ~123GB IQ1_S GGUF for 256GB-class machines, and the 2.4T A95B stays API-only in practice. The mid range covers Qwen3 8B (the 16GB-machine pick) and Qwen3 14B, then steps down to Qwen3.5 4B and the phone-class 0.5B models.
All Qwen Models
| Model | Size | Quant | VRAM | Min RAM | Best For | Quality | Ollama |
|---|---|---|---|---|---|---|---|
| Qwen2.5 0.5B Instruct | 0.5B | Q4_K_M | 0.8 GB | 2 GB | Chat, Mobile | 42 | |
| Qwen3.5 0.8B Instruct | 0.8B | Q4_K_M | 0.8 GB | 2 GB | Chat, Mobile | 56 | |
| Qwen2.5 1.5B Instruct | 1.5B | Q4_K_M | 1.5 GB | 4 GB | Chat, Translation | 55 | |
| Qwen3.5 2B Instruct | 2B | Q4_K_M | 1.8 GB | 4 GB | Chat, Edge tasks | 70 | |
| Qwen2.5 3B Instruct | 3B | Q4_K_M | 2.5 GB | 4 GB | Chat, Coding | 62 | |
| Qwen3.5 4B Instruct | 4B | Q4_K_M | 3.5 GB | 6 GB | Coding, Agents, Multimodal | 83 | |
| Qwen3.5 4B Instruct (Q8) | 4B | Q8_0 | 4.3 GB | 8 GB | Coding, Agents, Multimodal | 85 | |
| Qwen2.5 7B Instruct | 7B | Q4_K_M | 5.5 GB | 8 GB | Chat, Coding | 74 | |
| Qwen2.5 Coder 7B | 7B | Q4_K_M | 5.5 GB | 8 GB | Coding | 78 | |
| Qwen3 8B | 8B | Q4_K_M | 6.5 GB | 12 GB | Chat, Coding | 84 | |
| Qwen3 8B (Q8) | 8B | Q8_0 | 8.1 GB | 16 GB | Chat, Coding | 86 | |
| Qwen3.5 9B Instruct | 9B | Q4_K_M | 7 GB | 12 GB | Quality, Coding, Reasoning | 89 | |
| Qwen3.5 9B Instruct (Q8) | 9B | Q8_0 | 10.7 GB | 16 GB | Quality, Coding, Reasoning | 91 | |
| Qwen2.5 14B Instruct | 14B | Q4_K_M | 11 GB | 16 GB | Coding, Chat | 82 | |
| Qwen2.5 Coder 14B | 14B | Q4_K_M | 11 GB | 16 GB | Coding | 85 | |
| Qwen3 14B | 14B | Q4_K_M | 11 GB | 16 GB | Coding, Quality | 88 | |
| Qwen3 14B (Q8) | 14B | Q8_0 | 15.9 GB | 24 GB | Coding, Quality | 90 | |
| Qwen3.5 27B Instruct | 27B | Q4_K_M | 16 GB | 24 GB | Chat, Coding, Complex reasoning | 91 | |
| Qwen3.5 27B Instruct (Q8) | 27B | Q8_0 | 27.1 GB | 48 GB | Chat, Coding, Complex reasoning | 93 | |
| Qwen3.6 27B | 27B | Q4_K_M | 18 GB | 32 GB | Coding, Quality, Long context | 94 | |
| Qwen3.8 27B | 27B | Q4_K_M | 16.5 GB | 24 GB | Coding, Agent, Vision, Long context | 94 | |
| Qwen3.8 27B (Q8) | 27B | Q8_0 | 27.1 GB | 48 GB | Coding, Agent, Vision, Long context | 96 | |
| Qwen3.6 27B (Q8) | 27B | Q8_0 | 30 GB | 48 GB | Coding, Quality, Long context | 96 | |
| Qwen3 30B | 30B | Q4_K_M | 22 GB | 32 GB | Quality, Coding | 89 | |
| Qwen3 30B (Q8) | 30B | Q8_0 | 30.3 GB | 48 GB | Quality, Coding | 91 | |
| Qwen3.5 35B-A3B Instruct | 35B | Q4_K_M | 20 GB | 32 GB | Reasoning, Coding, Agent scenarios | 93 | |
| Qwen3.6 35B-A3B | 35B | Q4_K_M | 22 GB | 32 GB | Reasoning, Coding, Agents | 95 | |
| Qwen3.6 35B-A3B (Q8) | 35B | Q8_0 | 38.7 GB | 64 GB | Reasoning, Coding, Agents | 97 | |
| Qwen3.5 35B-A3B Instruct (Q8) | 35B | Q8_0 | 38.7 GB | 64 GB | Reasoning, Coding, Agent scenarios | 95 | |
| Qwen3-Next 80B-A3B | 80B | Q4_K_M | 50.4 GB | 72 GB | Chat, Coding, Long Context | 94 | |
| Qwen3-Next 80B-A3B (Q8) | 80B | Q8_0 | 84.8 GB | 128 GB | Chat, Coding, Long Context | 96 | |
| Qwen3.5 122B-A10B Instruct | 122B | Q4_K_M | 72 GB | 96 GB | Frontier-level reasoning, Complex tasks | 97 | |
| Qwen3.8-Flash-Next | 125B | IQ1_S | 123 GB | 192 GB | Agentic coding, Reasoning, Multimodal | 92 | N/A |
| Qwen3 235B A22B | 235B | Q4_K_M | 130 GB | 192 GB | Quality, Reasoning | 98 |
Cloud / API-only models
Weights are open but far beyond consumer hardware — these run as APIs. Each page lists the local alternatives.
| Model | Size | Access | Best For |
|---|---|---|---|
| Qwen3.7-Plus | Undisclosed | API only | Multimodal, Agentic, Vision |
| Qwen3.8 2.4T A95B | 2400B | API only | Frontier reasoning, Agentic coding |
Device Compatibility
Which Qwen models can run on each device class, based on minimum RAM requirements.
| Model | iPhone | Air | Pro | Studio | Mini |
|---|---|---|---|---|---|
| Qwen2.5 0.5B Instruct (0.5B) | Excellent | Excellent | Excellent | Excellent | Excellent |
| Qwen3.5 0.8B Instruct (0.8B) | Excellent | Excellent | Excellent | Excellent | Excellent |
| Qwen2.5 1.5B Instruct (1.5B) | Excellent | Excellent | Excellent | Excellent | Excellent |
| Qwen3.5 2B Instruct (2B) | Excellent | Excellent | Excellent | Excellent | Excellent |
| Qwen2.5 3B Instruct (3B) | Excellent | Excellent | Excellent | Excellent | Excellent |
| Qwen3.5 4B Instruct (4B) | Possible | Possible | Excellent | Excellent | Excellent |
| Qwen3.5 4B Instruct (Q8) (4B) | Possible | Possible | Excellent | Excellent | Excellent |
| Qwen2.5 7B Instruct (7B) | Possible | Possible | Excellent | Excellent | Excellent |
| Qwen2.5 Coder 7B (7B) | Possible | Possible | Excellent | Excellent | Excellent |
| Qwen3 8B (8B) | Possible | Possible | Possible | Excellent | Possible |
| Qwen3 8B (Q8) (8B) | No | Possible | Possible | Excellent | Possible |
| Qwen3.5 9B Instruct (9B) | Possible | Possible | Possible | Excellent | Possible |
| Qwen3.5 9B Instruct (Q8) (9B) | No | Possible | Possible | Excellent | Possible |
| Qwen2.5 14B Instruct (14B) | No | Possible | Possible | Excellent | Possible |
| Qwen2.5 Coder 14B (14B) | No | Possible | Possible | Excellent | Possible |
| Qwen3 14B (14B) | No | Possible | Possible | Excellent | Possible |
| Qwen3 14B (Q8) (14B) | No | Possible | Possible | Possible | Possible |
| Qwen3.5 27B Instruct (27B) | No | Possible | Possible | Possible | Possible |
| Qwen3.5 27B Instruct (Q8) (27B) | No | No | Possible | Possible | Possible |
| Qwen3.6 27B (27B) | No | Possible | Possible | Possible | Possible |
| Qwen3.8 27B (27B) | No | Possible | Possible | Possible | Possible |
| Qwen3.8 27B (Q8) (27B) | No | No | Possible | Possible | Possible |
| Qwen3.6 27B (Q8) (27B) | No | No | Possible | Possible | Possible |
| Qwen3 30B (30B) | No | Possible | Possible | Possible | Possible |
| Qwen3 30B (Q8) (30B) | No | No | Possible | Possible | Possible |
| Qwen3.5 35B-A3B Instruct (35B) | No | Possible | Possible | Possible | Possible |
| Qwen3.6 35B-A3B (35B) | No | Possible | Possible | Possible | Possible |
| Qwen3.6 35B-A3B (Q8) (35B) | No | No | Possible | Possible | Possible |
| Qwen3.5 35B-A3B Instruct (Q8) (35B) | No | No | Possible | Possible | Possible |
| Qwen3-Next 80B-A3B (80B) | No | No | Possible | Possible | No |
| Qwen3-Next 80B-A3B (Q8) (80B) | No | No | Possible | Possible | No |
| Qwen3.5 122B-A10B Instruct (122B) | No | No | Possible | Possible | No |
| Qwen3.8-Flash-Next (125B) | No | No | No | Possible | No |
| Qwen3 235B A22B (235B) | No | No | No | Possible | No |