Encuentra el mejor modelo de IA local para tu dispositivo
ModelFit es una herramienta gratuita que te dice qué modelos de IA locales funcionan en tu hardware. Indícanos tu hardware y obtén el mejor LLM local que realmente puede ejecutar, ajustado a tu memoria exacta. Estimaciones honestas de velocidad y calidad para Apple Silicon, iPhone, NVIDIA y AMD.
¿Cuál es la velocidad real de tu máquina?
Un solo comando muestra tus tok/s reales, y luego una tarjeta para publicar en X y tu posición en la clasificación. Te pide permiso antes de enviar nada.
¿No tienes Node? brew tap modelfit-io/tap, brew trust modelfit-io/tap, brew install modelfit, y luego modelfit bench. La primera ejecución descarga de 3 a 17 GB.
- Modelos analizados
- 201
- Se ejecutan en local
- 157
- Dispositivos y GPU
- 71
~ $ npx @modelfit/cli@latest bench
  run 1/3: 132.6 tok/s
  run 2/3: 155.3 tok/s
  run 3/3: 150.0 tok/s
  150.0 tok/s on Qwen3.8 27B, #1 of 12
  Your card, ready to post on X:
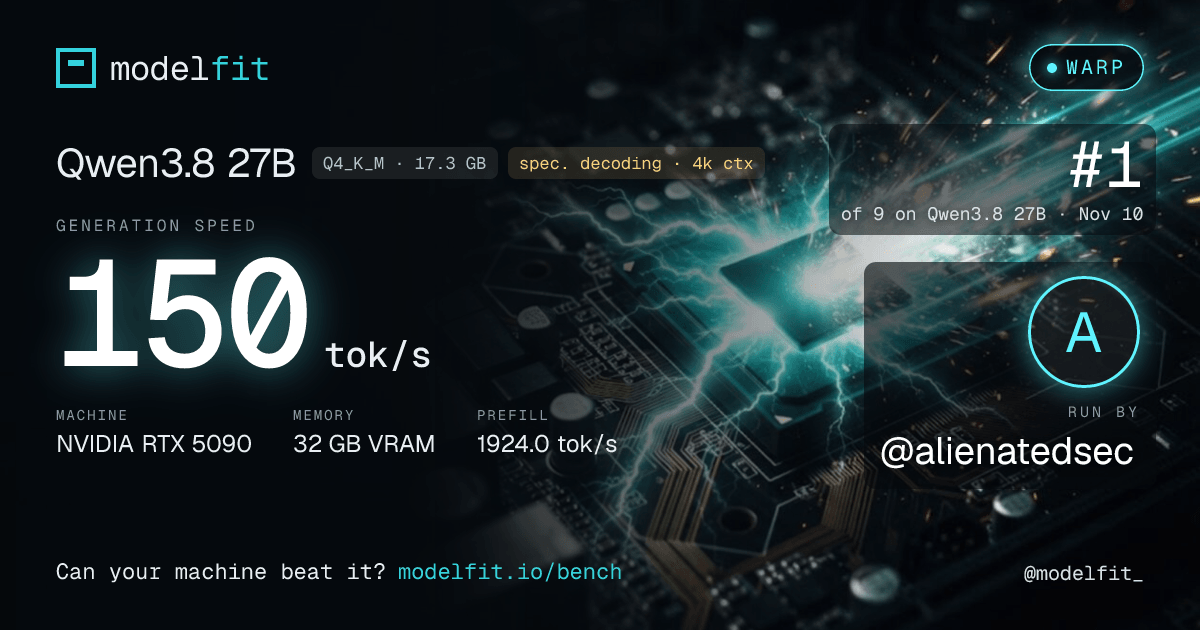
A real run from the leaderboard, Nov 10.
Choose your device
We match models to your exact memory and architecture.
Elige tu modelo en una línea, cronometra tu máquina en otra
El CLI gratuito de ModelFit, sin dependencias, detecta tu hardware exacto, elige el mejor modelo local que puede ejecutar y te da el comando de Ollama de una línea para instalarlo. El segundo comando cronometra con Ollama un modelo que cabe en tu máquina y te pide permiso antes de añadir tu velocidad a la clasificación pública de abajo. El conjunto de datos que lo alimenta es abierto (CC BY 4.0), y los agentes de IA pueden consultarlo en directo mediante MCP.
- 1 · Elegir el mejor modelo$npx @modelfit/cli@latest
- 2 · Cronometrar tu velocidad real$npx @modelfit/cli@latest bench
¿Dónde se sitúa tu máquina?
Clasificación completa →Todas las demás velocidades de ModelFit son estimaciones. Estas son ejecuciones reales: los lectores cronometran Qwen3.8 27B con los mismos prompts en su propio Mac o GPU, así que las barras son comparables. 15 ejecuciones de 12 máquinas hasta ahora.
Aún no están en la clasificación: M5, RTX 4090, RTX 3090, M3, RTX 4060, M2, RTX 4070, M3 Pro, RTX 5080, M3 Max. ¿Tienes alguna? El segundo comando de arriba la añade. 4 máquinas más están en la clasificación completa.
Mediana de las ejecuciones de cada máquina, velocidad de generación según la informa Ollama. Requiere Node y Ollama. El CLI te pide permiso antes de enviar nada: tipo de máquina, memoria, versión de Ollama y tiempos (sin nombre, sin correo, sin archivos). Las nuevas ejecuciones llegan a este gráfico en la próxima actualización del sitio y a la clasificación completa de inmediato.
Últimos artículos del blog (en inglés)
Ver todo → 19 nov 2026
Microsoft Aion 1.0 Instruct 2.3B: What Hardware Runs It?
Microsoft published Aion 1.0 Instruct on Hugging Face on 18 November 2026: microsoft/Aion-1.0-Instruct-2.3B, from the Windows Applied Sciences Group, under the MIT license (microsoft/Aion-1.0-Instruct...
- 17 nov 2026
Tencent Hy4 Flash Weights Are Out: What Hardware Runs It?
Tencent published the Hy4 flash weights on Hugging Face on 17 November 2026: tencent/Hy4-flash, tencent/Hy4-flash-FP8 and tencent/Hy4-flash-base, none of them gated (tencent/Hy4-flash, 2026). The mode...
- 16 nov 2026
Qwen4-Max Is Out of Preview: 2.4T Parameters, Still No Weights
Alibaba made Qwen4-Max generally available on 16 November 2026, five days after the Qwen4-Max preview. The model ID is now qwen4-max, it has a per-token price, and the Qwen team published its size: a ...
- 14 nov 2026
llama.cpp 1.0 on a Mac: CLI Keeps Working, Ripple 65B Needs 64GB
llama.cpp 1.0.0 shipped on November 13, 2026, and for most Mac users nothing breaks. The release removes 35 deprecated functions from the llama.h C API, so apps and language bindings that still call t...
¿Cuánto LLM cabe en tu memoria?
Todas las estadísticas →Un LLM local necesita aproximadamente 0.6 GB por cada mil millones de parámetros en Q4. ModelFit ajusta sus recomendaciones a ~70% de tu memoria unificada en máquinas de hasta 32GB, y a ~85% a partir de 128GB, dejando margen para el sistema, el contexto y la caché KV. Esto es lo que cada nivel ejecuta con holgura hoy. El mismo cálculo vale para la VRAM de las GPU: para tarjetas dedicadas, consulta las guías de GPU tarjeta por tarjeta.
| Memoria unificada | Tamaño máx. (denso) | Mejor opción local | Modelos que caben |
|---|---|---|---|
| 8 GB | ~9B de parámetros | Qwen3.5 4B Instruct | 36 de 157 |
| 12 GB | ~12B de parámetros / 12.1B MoE | LFM2.5 8B-A1B | 56 de 157 |
| 16 GB | ~14B de parámetros | Qwen3.5 9B Instruct | 67 de 157 |
| 24 GB | ~29.3B de parámetros | LFM2 24B-A2B Instruct | 82 de 157 |
| 32 GB | ~33.1B de parámetros / 35.95B MoE | Qwen3.8 27B | 106 de 157 |
| 36 GB | ~33.1B de parámetros / 39.8B MoE | Qwen3.6 35B-A3B | 111 de 157 |
| 48 GB | ~33.1B de parámetros / 46.7B MoE | Qwen3.6 35B-A3B | 121 de 157 |
| 64 GB | ~70B de parámetros / 78.1B MoE | Nemotron 3.5 Lightning 30B-A3B | 130 de 157 |
| 72 GB | ~70B de parámetros / 80B MoE | Kolibri 1 (IQ4_XS) | 132 de 157 |
| 96 GB | ~123B de parámetros / 125.09B MoE | Kolibri 1 | 142 de 157 |
| 128 GB | ~123B de parámetros / 125.09B MoE | Qwen3.5 122B-A10B Instruct | 148 de 157 |
| 192 GB | ~123B de parámetros / 235B MoE | Qwen3.8-Flash-Next | 150 de 157 |
| 256 GB | ~123B de parámetros / 428B MoE | Qwen3.8-Flash-Next | 151 de 157 |
| 512 GB | ~123B de parámetros / 770B MoE | MiniMax M3.1 Flash | 157 de 157 |
Calculado a partir del catálogo propio de ModelFit, con 201 modelos · conjunto de datos actualizado el 2026-11-16 · conjunto de datos completo (CC BY 4.0)
Haz tu propio cálculo: calculadora de VRAM, respuestas por GPU, VRAM según el tamaño del modelo, RAM frente a VRAM o la calculadora de memoria completa.
Local frente a la nube: ¿cuánta distancia queda?
Benchmark completo →Los modelos de pesos abiertos que puedes ejecutar en casa siguen acortando la distancia con las mejores API cerradas en programación. Esto es lo que muestra hoy la línea en SWE-Bench Verified.
SWE-Bench Verified · puntuaciones de terceros, cada una confirmada en la fuente primaria del modelo. Qwen3.8-27B se ejecuta en local en un 24GB Mac.
Recorre todo el índice
Todos los dispositivos →Preguntas frecuentes sobre LLM locales
¿Cuánta memoria necesito para ejecutar un LLM local?
Un modelo local necesita aproximadamente 0.6 GB de memoria por cada mil millones de parámetros con cuantización Q4 para los pesos, más cerca de 0.8 GB por mil millones por debajo de 8B una vez contada la sobrecarga de ejecución. ModelFit ajusta sus recomendaciones a cerca del 70% de la memoria unificada de tu dispositivo (hasta ~85% en máquinas de 128GB+), así que una máquina de 8GB ejecuta con holgura modelos densos de hasta ~9B y una de 16GB de hasta ~14B de parámetros. Los modelos de mezcla de expertos (MoE) admiten más parámetros en total porque solo una fracción está activa por token.
¿Cuál es el mejor LLM local para un Mac de 16GB?
En un Mac de 16GB, la mejor opción de ModelFit es Qwen3.5 9B Instruct (Q4_K_M): se carga en unos 7GB y queda primero según el equilibrio del motor entre calidad, velocidad y margen de memoria, la misma opción que da la calculadora. 67 de los 157 modelos locales de ModelFit caben en un dispositivo de 16GB.
¿Puedo ejecutar estos modelos completamente sin conexión?
Sí. Todos los modelos locales que recomienda ModelFit se ejecutan totalmente sin conexión en tu propio hardware, con Ollama o, para las versiones sin etiqueta de Ollama, con llama.cpp, LM Studio o MLX: sin claves de API, sin suscripción y sin que ningún dato salga de tu máquina.
¿Cuántos modelos de IA cubre ModelFit?
ModelFit sigue 201 modelos de IA repartidos en 41 familias; 157 se ejecutan en local en hardware Apple Silicon, NVIDIA o AMD, y 126 de ellos tienen una etiqueta de Ollama verificada en el registro.
¿Hasta qué punto son fiables las estimaciones de velocidad?
Las cifras de tokens por segundo son estimaciones de ModelFit, calculadas a partir del ancho de banda de memoria de tu chip o GPU y del tamaño del modelo, y no cifras obtenidas en una máquina. La velocidad real varía según la cuantización, la longitud del contexto y el estado térmico.