Trouvez le meilleur modèle d’IA local pour votre appareil
ModelFit est un outil gratuit qui vous dit quels modèles d’IA locaux tournent sur votre matériel. Indiquez votre matériel et obtenez le meilleur LLM local qu’il peut réellement faire tourner, dimensionné selon votre mémoire exacte. Des estimations honnêtes de vitesse et de qualité pour Apple Silicon, iPhone, NVIDIA et AMD.
Quelle est la vitesse réelle de votre machine ?
Une seule commande affiche vos tok/s réels, puis une carte à publier sur X et votre rang dans le classement. Elle demande votre accord avant d’envoyer quoi que ce soit.
Pas de Node ? brew tap modelfit-io/tap, brew trust modelfit-io/tap, brew install modelfit, puis modelfit bench. Le premier lancement télécharge de 3 à 17 GB.
- Modèles suivis
- 201
- Tournent en local
- 157
- Appareils et GPU
- 71
~ $ npx @modelfit/cli@latest bench
  run 1/3: 132.6 tok/s
  run 2/3: 155.3 tok/s
  run 3/3: 150.0 tok/s
  150.0 tok/s on Qwen3.8 27B, #1 of 12
  Your card, ready to post on X:
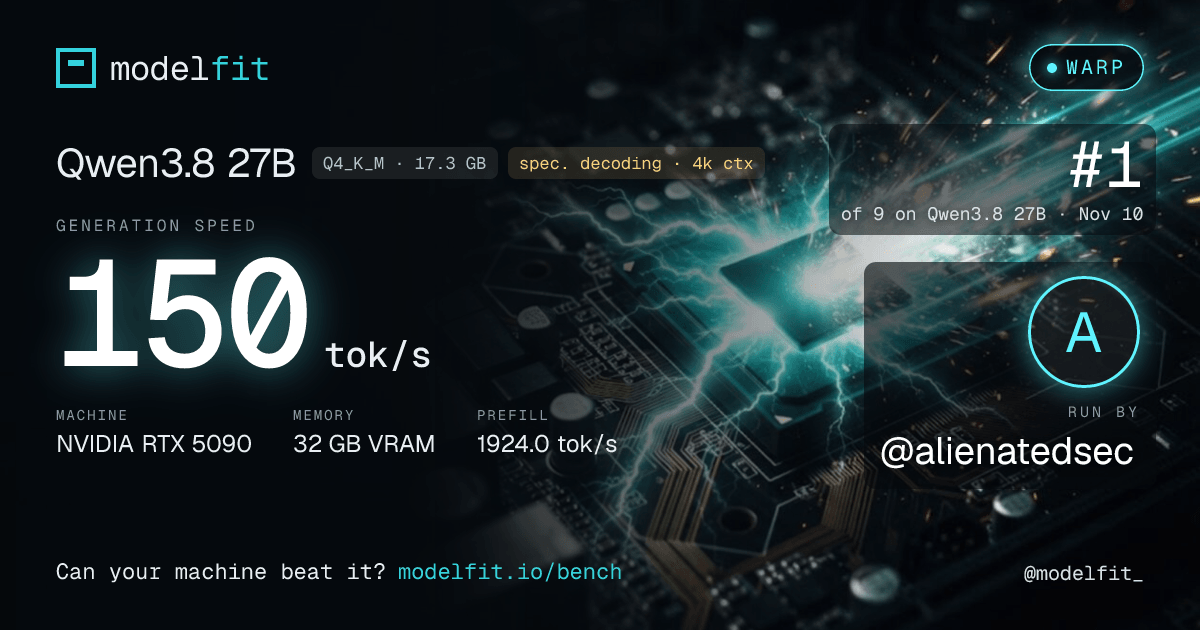
A real run from the leaderboard, Nov 10.
Choose your device
We match models to your exact memory and architecture.
Choisissez votre modèle en une ligne, chronométrez votre machine en une autre
Le CLI gratuit de ModelFit, sans aucune dépendance, détecte votre matériel exact, choisit le meilleur modèle local qu'il peut faire tourner et vous donne la commande Ollama en une ligne pour l'installer. La seconde commande chronomètre un modèle adapté à votre machine avec Ollama et demande votre accord avant d'ajouter votre vitesse au classement public ci-dessous. Le jeu de données qui l'alimente est ouvert (CC BY 4.0), et les agents IA peuvent l'interroger en direct via MCP.
- 1 · Choisir le meilleur modèle$npx @modelfit/cli@latest
- 2 · Chronométrer votre vitesse réelle$npx @modelfit/cli@latest bench
Où se place votre machine ?
Classement complet →Toutes les autres vitesses de ModelFit sont des estimations. Ici, ce sont de vraies exécutions : des lecteurs font tourner Qwen3.8 27B avec les mêmes prompts sur leur propre Mac ou GPU, donc les barres sont comparables. 15 exécutions sur 12 machines à ce jour.
Pas encore au classement : M5, RTX 4090, RTX 3090, M3, RTX 4060, M2, RTX 4070, M3 Pro, RTX 5080, M3 Max. Vous en avez une ? La seconde commande ci-dessus l’ajoute. 4 autres machines figurent dans le classement complet.
Médiane des exécutions de chaque machine, vitesse de génération telle que rapportée par Ollama. Nécessite Node et Ollama. Le CLI demande votre accord avant d'envoyer quoi que ce soit : type de machine, mémoire, version d'Ollama et durées (ni nom, ni e-mail, ni fichiers). Les nouvelles exécutions apparaissent dans ce graphique à la prochaine mise à jour du site, et dans le classement complet immédiatement.
Derniers articles du blog (en anglais)
Tout voir → 17 nov. 2026
Tencent Hy4 Flash Weights Are Out: What Hardware Runs It?
Tencent published the Hy4 flash weights on Hugging Face on 17 November 2026: tencent/Hy4-flash, tencent/Hy4-flash-FP8 and tencent/Hy4-flash-base, none of them gated (tencent/Hy4-flash, 2026). The mode...
- 16 nov. 2026
Qwen4-Max Is Out of Preview: 2.4T Parameters, Still No Weights
Alibaba made Qwen4-Max generally available on 16 November 2026, five days after the Qwen4-Max preview. The model ID is now qwen4-max, it has a per-token price, and the Qwen team published its size: a ...
- 14 nov. 2026
llama.cpp 1.0 on a Mac: CLI Keeps Working, Ripple 65B Needs 64GB
llama.cpp 1.0.0 shipped on November 13, 2026, and for most Mac users nothing breaks. The release removes 35 deprecated functions from the llama.h C API, so apps and language bindings that still call t...
- 13 nov. 2026
Gemini 4 Hydrogen Is Cloud Only: No Weights, No Local Run
Google DeepMind introduced Gemini 4 Hydrogen on 12 November 2026 (Google DeepMind, 2026). It is the fast member of the Gemini 4 family, built for everyday coding and agentic workflows, next to the fro...
Quelle taille de LLM tient dans votre mémoire ?
Toutes les stats →Un LLM local demande environ 0.6 GB par milliard de paramètres en Q4. ModelFit dimensionne ses choix à ~70% de votre mémoire unifiée sur les machines jusqu'à 32GB, puis ~85% à partir de 128GB, en gardant de la marge pour le système, le contexte et le cache KV. Voici ce que chaque palier fait tourner confortablement aujourd'hui. Le même calcul vaut pour la VRAM des GPU : pour les cartes dédiées, consultez les guides GPU carte par carte.
| Mémoire unifiée | Taille max. (dense) | Meilleur choix local | Modèles qui tiennent |
|---|---|---|---|
| 8 GB | ~9B de paramètres | Qwen3.5 4B Instruct | 36 sur 157 |
| 12 GB | ~12B de paramètres / 12.1B MoE | LFM2.5 8B-A1B | 56 sur 157 |
| 16 GB | ~14B de paramètres | Qwen3.5 9B Instruct | 67 sur 157 |
| 24 GB | ~29.3B de paramètres | LFM2 24B-A2B Instruct | 82 sur 157 |
| 32 GB | ~33.1B de paramètres / 35.95B MoE | Qwen3.8 27B | 106 sur 157 |
| 36 GB | ~33.1B de paramètres / 39.8B MoE | Qwen3.6 35B-A3B | 111 sur 157 |
| 48 GB | ~33.1B de paramètres / 46.7B MoE | Qwen3.6 35B-A3B | 121 sur 157 |
| 64 GB | ~70B de paramètres / 78.1B MoE | Nemotron 3.5 Lightning 30B-A3B | 130 sur 157 |
| 72 GB | ~70B de paramètres / 80B MoE | Kolibri 1 (IQ4_XS) | 132 sur 157 |
| 96 GB | ~123B de paramètres / 125.09B MoE | Kolibri 1 | 142 sur 157 |
| 128 GB | ~123B de paramètres / 125.09B MoE | Qwen3.5 122B-A10B Instruct | 148 sur 157 |
| 192 GB | ~123B de paramètres / 235B MoE | Qwen3.8-Flash-Next | 150 sur 157 |
| 256 GB | ~123B de paramètres / 428B MoE | Qwen3.8-Flash-Next | 151 sur 157 |
| 512 GB | ~123B de paramètres / 770B MoE | MiniMax M3.1 Flash | 157 sur 157 |
Calculé à partir du catalogue de ModelFit, soit 201 modèles · jeu de données mis à jour le 2026-11-16 · jeu de données complet (CC BY 4.0)
Faites votre propre calcul : calculateur de VRAM, réponses par GPU, VRAM selon la taille du modèle, RAM ou VRAM ou le calculateur de mémoire complet.
Local contre cloud : où en est-on ?
Benchmark complet →Les modèles à poids ouverts que vous pouvez faire tourner chez vous réduisent peu à peu l'écart avec les meilleures API fermées en programmation. Voici où se situe la ligne aujourd'hui sur SWE-Bench Verified.
SWE-Bench Verified · scores de tiers, chacun vérifié dans la source primaire du modèle. Qwen3.8-27B tourne en local sur un 24GB Mac.
Parcourir tout l’index
Tous les appareils →Questions fréquentes sur les LLM locaux
De quelle mémoire ai-je besoin pour faire tourner un LLM local ?
Un modèle local demande environ 0.6 GB de mémoire par milliard de paramètres en quantification Q4 pour les poids, plutôt 0.8 GB par milliard sous 8B une fois le surcoût d'exécution compté. ModelFit dimensionne ses choix à environ 70% de la mémoire unifiée de votre appareil (jusqu'à ~85% sur les machines de 128GB+), donc une machine de 8GB fait tourner confortablement des modèles denses jusqu'à ~9B et une machine de 16GB jusqu'à ~14B de paramètres. Les modèles MoE (mixture of experts) tiennent plus de paramètres au total, car seule une fraction est active par token.
Quel est le meilleur LLM local pour un Mac de 16GB ?
Sur un Mac de 16GB, le meilleur choix de ModelFit est Qwen3.5 9B Instruct (Q4_K_M) : il se charge en environ 7GB et arrive en tête selon l'équilibre du moteur entre qualité, vitesse et marge de mémoire, le même choix que le calculateur. 67 des 157 modèles locaux de ModelFit tiennent sur un appareil de 16GB.
Puis-je faire tourner ces modèles entièrement hors ligne ?
Oui. Chaque modèle local recommandé par ModelFit tourne entièrement hors ligne sur votre propre matériel, via Ollama ou, pour les builds sans tag Ollama, llama.cpp, LM Studio ou MLX : pas de clé d'API, pas d'abonnement, et aucune donnée ne quitte votre machine.
Combien de modèles d'IA ModelFit couvre-t-il ?
ModelFit suit 201 modèles d'IA répartis en 41 familles ; 157 tournent en local sur Apple Silicon, NVIDIA ou AMD, dont 126 avec un tag Ollama vérifié sur le registre.
Quelle est la fiabilité des estimations de vitesse ?
Les chiffres en tokens par seconde sont des estimations de ModelFit, calculées à partir de la bande passante mémoire de votre puce ou GPU et de la taille du modèle, et non des chiffres relevés sur une machine. La vitesse réelle varie selon la quantification, la longueur de contexte et l'état thermique.